
🎉 开源音频模型变天了!
https://huggingface.co/collections/inclusionAI/ming-30
蚂蚁这次开源 Ming 3.0有点东西,某些闭源商业公司躺着数钱的日子到头了
这次深度体验了它的 TTS 模型,堪称导演级语音合成!支持:
- 声音克隆/设计
- 控制情绪、重读、副词语气
配音说话终于不像机器人了
这套模型基于 MIT 协议完全免费商用,支持一键部署它由三款核心模型组成,直接打通了全栈音频工作流:
- Ming-3.0-tts(语音合成):声音克隆与语气控制极强,原生支持多音色并发,适合一键生成高质量“多人播客
- Ming-3.0-audio(音频推理):1260 亿 MoE 大模型,懂环境音和说话人身份,与 TTS 无缝拼接,就能秒变同声传译工作流!
- Ming-3.0-asr(语音识别):极其轻量、高精度的转写模型,适合本地会议纪要或实时语音输入
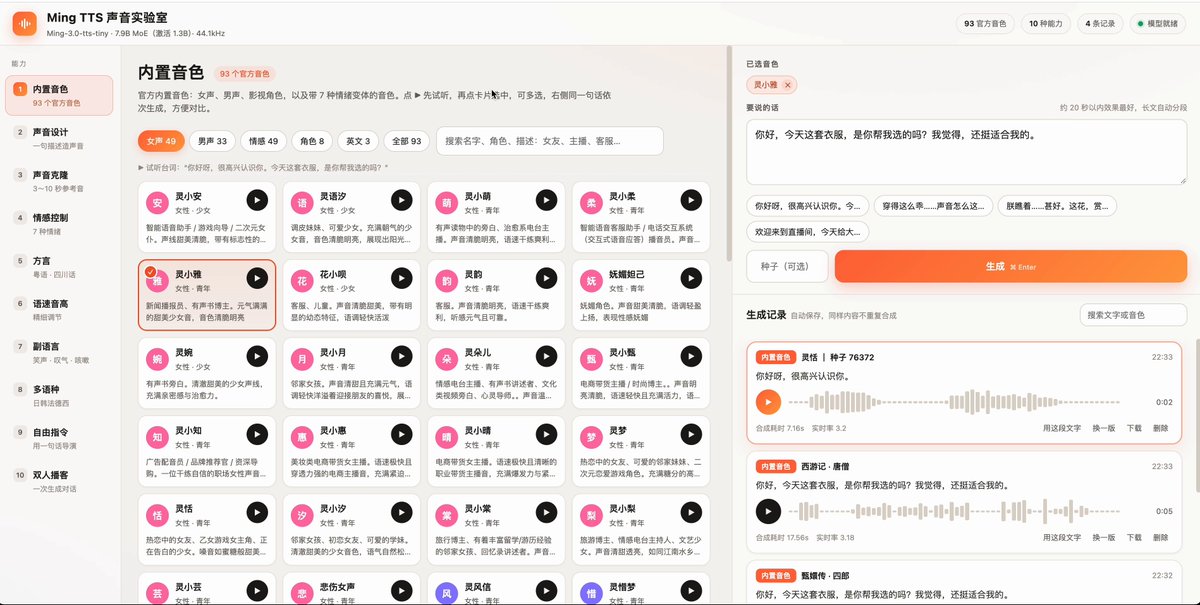
做了一个可视化操作页面演示下TTS能力 👇🏻
 主楼